正则表达式
系列【正则表达式】——把搜索到的内容重新排列后再替换
上一篇《系列【正则表达式】──用一个表达式搜索不同日期》写出了这个正则表达式:
\d{4}年\d{1,2}月\d{1,2}日
它可以一次搜索到类似下面这些日期:
这次我们再往前一步。
假设想把:
2026年9月1日
改成:
9/1/2026
这里并不是把整个日期替换成一段固定文字,而是要保留原来搜索到的年、月、日,只改变它们的排列顺序。
这时就要用到捕获组。
把之后还要用的部分放进括号
上一篇的搜索表达式是:
\d{4}年\d{1,2}月\d{1,2}日
之后还要继续使用的部分有三个:
- “年”前面的 4 位数字
- “月”前面的 1~2 位数字
- “日”前面的 1~2 位数字
因此,把这三个部分分别放进括号:
(\d{4})年(\d{1,2})月(\d{1,2})日
和上一篇相比,只是增加了三组括号。
像 (\d{4}) 这样,把正则表达式的一部分放进括号后,这一部分实际匹配到的文字就可以保留下来,稍后再次使用。
以 2026年9月1日 为例:
- (\d{4}) 匹配到
2026 - 第一个 (\d{1,2}) 匹配到
9 - 第二个 (\d{1,2}) 匹配到
1
可以把它想成把三个搜索结果临时放进三个带编号的盒子里。
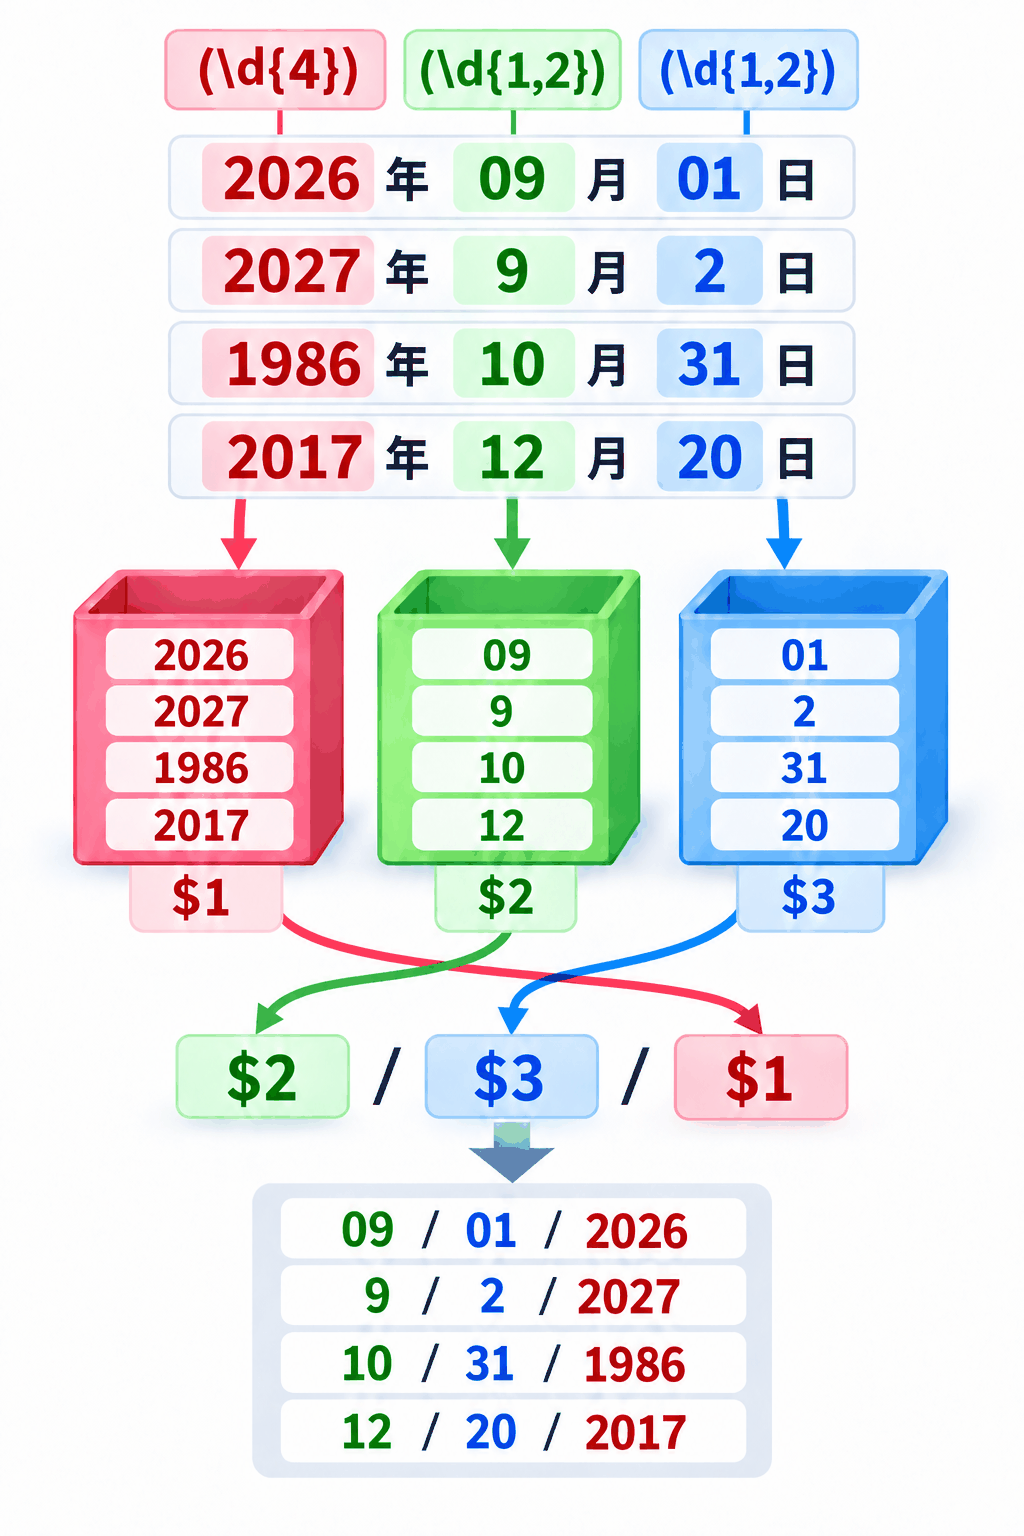
图1 括号里的部分会保存为 $1、$2、$3,替换时再按需要的顺序放回去
| 捕获组 | 保存的内容 | 2026年9月1日 时 |
|---|---|---|
| $1 | “年”前面的 4 位数字 | 2026 |
| $2 | “月”前面的 1~2 位数字 | 9 |
| $3 | “日”前面的 1~2 位数字 | 1 |
捕获组会按照括号从左到右的顺序编号。
这种用括号保存下来的部分,在正则表达式里叫做捕获组。
名字听起来有点技术化,但一开始只要记住:
把之后还要用的内容放进带编号的盒子里。
这样就够了。
用 $1、$2、$3 把盒子里的内容取出来
现在:
- 年在 $1
- 月在 $2
- 日在 $3
如果想改成“月/日/年”的顺序,替换字符串可以写成:
$2/$3/$1
也就是:
- $2 →
9 - $3 →
1 - $1 →
2026
最终得到:
9/1/2026
这里没有重新计算任何数字,只是把刚才存进盒子里的三段文字,按新的顺序取出来。
补充:捕获组的引用写法取决于工具
本文按照 memoQ 使用的格式,用 $1、$2、$3 表示替换时要取出的捕获内容。其他工具或正则表达式引擎也可能使用 \1、\2、\3 等写法。
另外,在日文系统或某些字体中,反斜杠 \ 有时会显示成半角日元符号 ¥。
搜索表达式不变,也可以只调整替换顺序
搜索表达式仍然是:
(\d{4})年(\d{1,2})月(\d{1,2})日
只改变替换字符串,就可以得到不同的格式。
例如:
- $2/$3/$1 →
9/1/2026 - $3/$2/$1 →
1/9/2026 - $1-$2-$3 →
2026-9-1
并不是重新搜索年、月、日,而是在决定刚才已经保存好的三段内容,要按什么顺序重新组合。
“年”“月”“日”为什么没有被保留下来?
再看一次搜索表达式:
(\d{4})年(\d{1,2})月(\d{1,2})日
年、月、日 虽然属于搜索条件的一部分,但它们没有放在括号里。
所以,这三个字会参与匹配,却不会被保存到 $1、$2、$3 中。
也就是说,我们可以把:
- 搜索时需要,但替换后不想保留的文字
- 搜索后还要继续使用的文字
分开处理。
这正是捕获组非常实用的地方。
$1 里的内容每次都可能不同
$1 并不永远等于 2026。
例如 2025年12月31日:
- $1 →
2025 - $2 →
12 - $3 →
31
而 1999年1月10日 则是:
- $1 →
1999 - $2 →
1 - $3 →
10
所以 $1、$2、$3 并不代表某个固定数字。
更容易理解的方式,是把它们看成“指向本次匹配结果的临时盒子”。
如果有编程经验,也可以把这个概念理解成有点类似临时变量。
替换并不会“理解”文字的含义
假设原文是:
2026年09月01日
使用:
$2/$3/$1
替换后会得到:
09/01/2026
而不是:
9/1/2026
因为 $2 里保存的是 09,$3 里保存的是 01。
正则表达式不会判断“这是月份,所以前导 0 可以删掉”,也不会替数字做计算。
它只是把搜索时保存下来的文字原样取出,再放到指定的位置。
实际工作中能怎么用?
本篇用日期来讲解,是因为数字最容易看清“抓到了什么,又放到了哪里”。
但捕获组当然不只可以保存数字。
像 portion、electrode 这样的单词,甚至由多个单词组成的名词短语,也可以搜索、保存,再放进新的字符串里。
例如技术文档中反复出现:
the portion where an electrode is provided
如果想统一成:
the portion on which an electrode is provided
即使其中的 portion 或 electrode 在不同句子中换成其他单词或名词短语,也可以把发生变化的部分捕获下来,再原样放回替换后的句型中。
换句话说,正则表达式处理的不一定是完全相同的字符串,也可以处理:
文字内容会变,但整体结构相同的模式。
单词和名词短语的搜索
本篇特意先用数字来讲解,是为了把捕获组和替换的机制看清楚。至于如何用正则表达式搜索会变化的单词、名词短语以及其他文字模式,会在后续文章中再单独介绍。
在翻译和 QA 工作中,“具体文字每次不同,但句型或结构反复出现”的情况并不少见,这正是捕获组非常好用的场景。
memoQ 的搜索和替换也可以使用这种方式。一次性进行大量替换之前,建议先检查匹配结果,确认只有预期内容会被修改。
这次先记住这几件事
把之后还要使用的部分放进括号:
(\d{4})年(\d{1,2})月(\d{1,2})日
括号会从左到右对应:
$1、$2、$3……
然后在替换字符串中,按照需要的顺序把它们放回去:
$2/$3/$1
于是:
2026年9月1日
就可以变成:
9/1/2026
一开始看到括号和 $1 可能有些陌生,但概念其实很简单:
先把需要的内容放进编号盒子,再按照想要的顺序取出来。
理解这一步以后,正则表达式就不只是“搜索工具”,还可以在保留关键信息的同时,大批量重新整理文字格式。